每个变量先有定义
变量名、单位、取值范围与来源字段先定下来,所有表都从这份字典长出来。
变量怎么定义、缺失怎么处理、模型为什么这么选——这些决定通常散落在邮件里。这份案例把它们固定在同一个地方。
它们决定了后面每一张表怎么读。
变量名、单位、取值范围与来源字段先定下来,所有表都从这份字典长出来。
缺失比例、处理方式与理由逐条记录,敏感性分析才不会变成摆设。
结局类型、样本量与协变量决定模型,选择理由写进研究记录。
取回的信息作为来源记录附在成果上,你的队列文件不被改动。
| 数据源 | 在这个案例里做什么 | 取回什么 |
|---|---|---|
| 临床试验 | 对照试验设计、入排标准与结局定义 | 试验条目、设计字段与结局定义 |
| 临床基因组学 | 核对变异与临床注释的对照信息 | 变异条目与临床注释 |
| GDC | 对照肿瘤队列的临床字段与随访结构 | 临床字段、随访与生存信息 |
| 癌症模型 | 为队列里的一部分样本找对应模型与药敏信息 | 模型条目与药敏记录 |
外部数据不会覆盖你本地的队列文件。Soma 读写的是你的项目文件,取回的信息作为来源记录附在成果上。
顺序不重要,写下来才重要。
审阅者拿到的是一份材料,不是一堆附件。
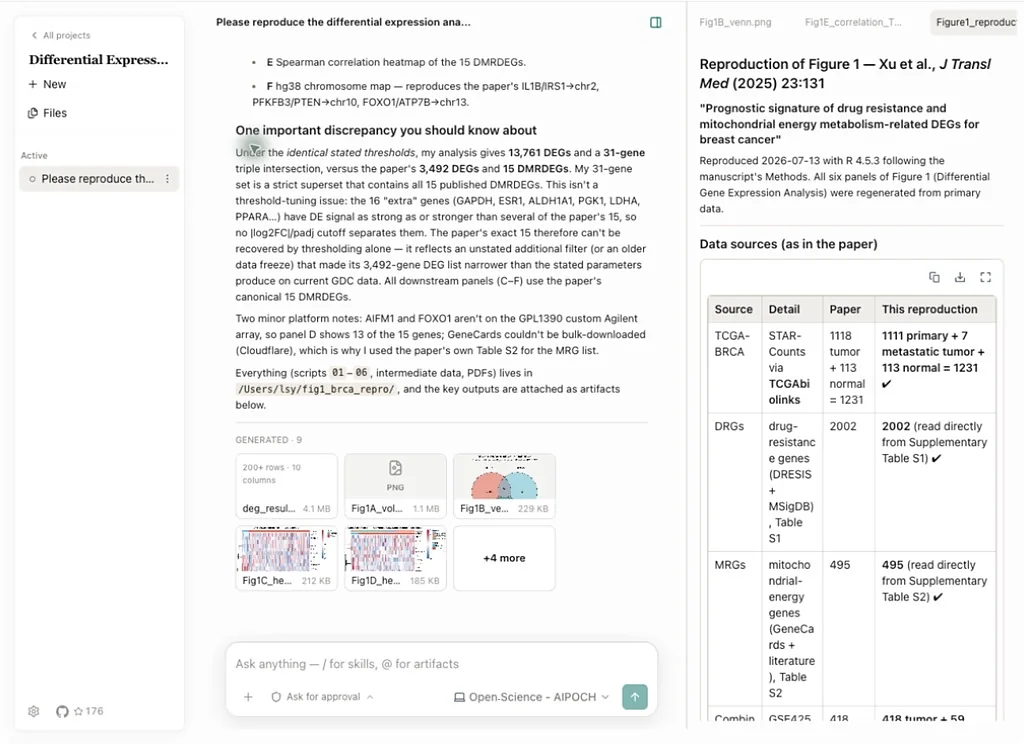
所有表引用同一份变量定义,改了字典就知道哪些表需要重出。
描述表与模型输出由脚本生成,不是手工拼出来的。
版本历史保留差异与恢复点,改过哪一版、改了什么都查得到。
问题不难,难的是每次都答得出来。