编号、版本与下载时间写进研究说明
半年后回看,仍然说得清当时用的是哪一版。
从定位数据集到质控、注释、整合与差异表达,每一步都留下脚本与输入文件。换一台机器、换一个同事,走的还是同一条路径。
公共数据最大的风险不是分析方法,是说不清用的是哪一版。
半年后回看,仍然说得清当时用的是哪一版。
过滤标准、双细胞与线粒体比例的界值先定,再动手分析。
脚本、环境与输入文件都留在研究里,不需要你的口头解释。
大结果集会先给预览并标注是预览,真正的分析在本地文件上跑。
| 数据源 | 在这个案例里做什么 | 取回什么 |
|---|---|---|
| 表达谱 | 按条件检索表达数据集与样本元数据 | 数据集条目、样本分组与元数据 |
| 组学档案 | 补检公共组学档案,确认数据集的完整版本 | 档案条目、版本与访问信息 |
| CELLxGENE Discover | 按细胞类型查看单细胞图谱,作为注释参照 | 细胞类型层次的表达图谱 |
| 细胞系 | 核对细胞系身份、来源与常见误认 | 细胞系条目与注释 |
组学数据体量大,Soma 会先给出预览并明确标注它只是预览,避免把抽样当成全量。分析所需的完整数据存放在本机。
每一步都有脚本或记录,不留口头约定。
如果图表只能靠手工调整,它就已经不是可复现的了。
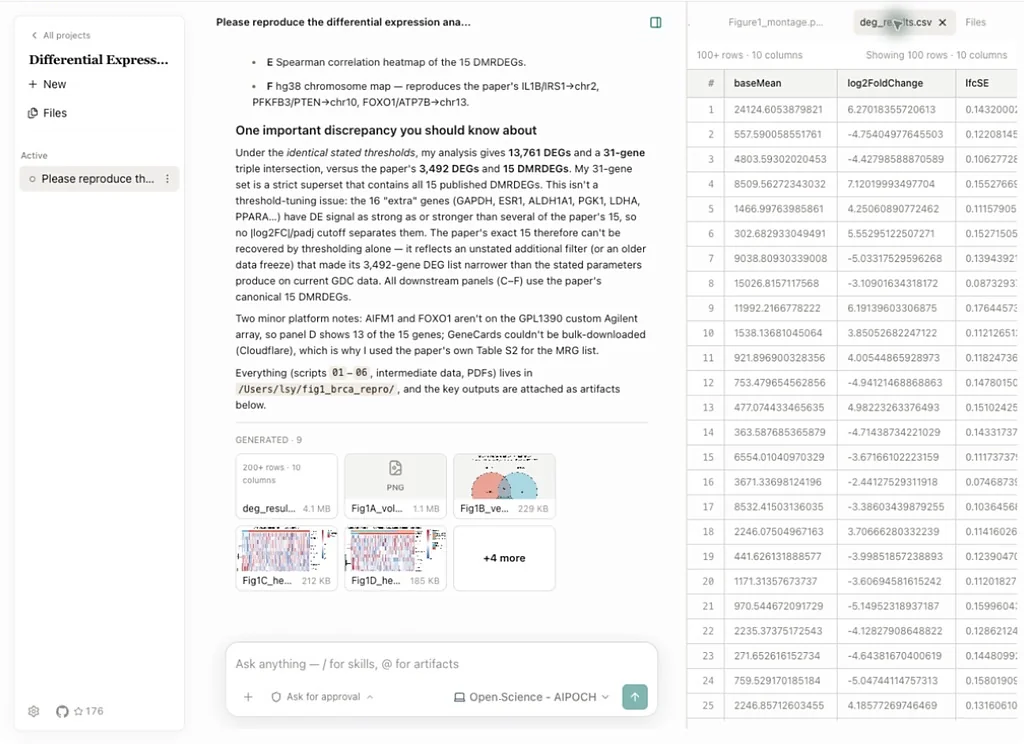
大表先给出行数、列名与类型,确认结构没问题再进分析。
Python 与 R 的依赖由 Soma 管理,环境变化会反映在版本记录里。
分析脚本与图表一起归档,改一行参数就能重出图。